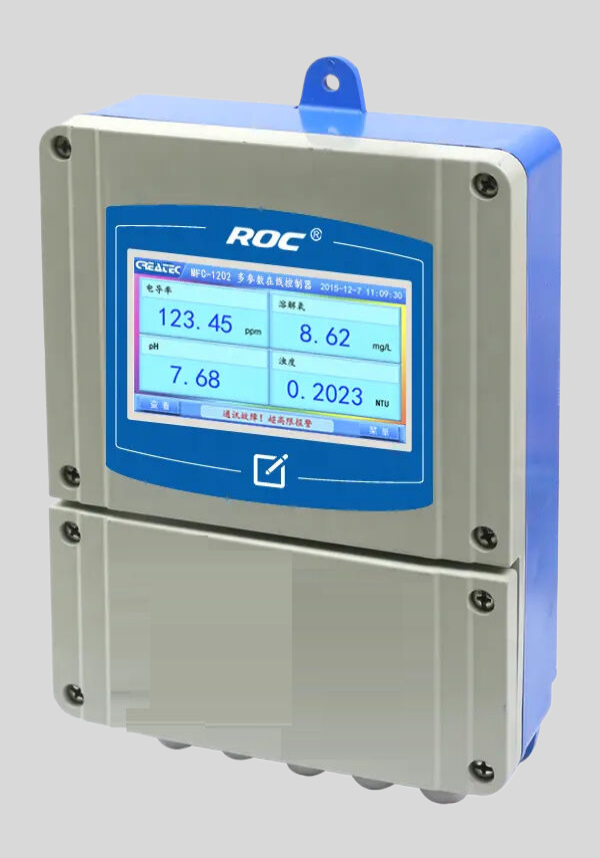
La surveillance de l’eau IoT promet des données continues, un accès à distance et des alertes automatisées. En pratique, la plupart des difficultés se situent à trois endroits : les capteurs dérivent, le réseau est peu fiable et le volume de données dépasse la capacité de les utiliser. Chacune de ces difficultés a des réponses d’ingénierie connues, mais les réponses sont architecturales — elles doivent être conçues dès le départ, et non ajoutées après la mise en service.
Table of Contents
Défi 1 : Précision des capteurs et dérive de calibration
Le Problème
Les capteurs de qualité de l’eau en ligne dérivent. Les électrodes de pH accumulent des contaminants dans la jonction de référence, les capteurs de conductivité développent des films de surface, les membranes d’oxygène dissous se dégradent et les points luminescents vieillissent. La dérive est progressive, donc elle ne déclenche pas d’alarme ; elle produit des lectures plausibles mais erronées qui maintiennent la boucle de contrôle en marche pendant que l’installation sort tranquillement de ses spécifications.
Les coûts qui en résultent sont indirects mais réels :
- Alertes de conformité fausses qui déclenchent des enquêtes inutiles
- Événements manqués, car un capteur dérivant ne peut pas montrer un changement brusque clairement
- Temps de travail dépensé sur des tentatives de calibration répétées qui ne corrigent pas la cause sous-jacente
- Remplacement prématuré, alors qu’un nettoyage ou un service de jonction de référence aurait restauré le capteur
L’Impact sur les Systèmes IoT
Lorsque des données peu fiables atteignent une plateforme :
- La détection d’anomalies génère des faux positifs et les opérateurs commencent à ignorer les alertes
- Les modèles de prédiction s’entraînent sur des historiques contaminés et reproduisent l’erreur
- Des réponses automatisées se déclenchent lorsqu’elles ne devraient pas, ce qui est toléré exactement une fois
- Les opérateurs perdent confiance dans le système de surveillance dans son ensemble, y compris les parties qui fonctionnent
Solutions Prouvées
Solution 1.1 : Vérification Automatisée de la Calibration
Des capteurs redondants avec validation croisée sont la réponse la plus forte lorsque la mesure est critique :
- Deux capteurs mesurent le même paramètre au même point
- Le système compare la divergence par rapport à l’incertitude attendue
- Une alerte est déclenchée lorsque la paire se sépare, avant que l’un ou l’autre ne soit prouvé erroné
Les capteurs de pH modernes en ligne avec surveillance d’impédance intégrée ajoutent un second signal : une impédance d’électrode croissante montre que la jonction de référence ou la membrane se dégrade bien avant que la valeur mesurée dérive visiblement, ce qui transforme une surprise en un service planifié.
Solution 1.2 : Technologie de Capteur Auto-Nettoyant
Le colmatage est la principale cause de dérive dans des conditions sales. Mécanismes disponibles :
- Nettoyage ultrasonique qui vibre la surface du capteur à environ 40 kHz
- Injection d’air pour empêcher la formation de biofilm
- Mécanismes d’essuyage automatiques sur les capteurs de turbidité et de solides en suspension
- Injection chimique pour nettoyer la zone de mesure sans retirer le capteur
Le bénéfice pratique est l’intervalle entre les services manuels, qui passe de semaines à mois dans les applications qui ont le plus besoin du matériel. Le bénéfice secondaire est que le nettoyage se produit selon le même calendrier que la calibration, ce qui rend la calibration valide.
Solution 1.3 : Redondance de Capteur Virtuel
L’apprentissage automatique peut créer une estimation basée sur un modèle d’un paramètre à partir d’autres, et l’utiliser comme vérification de santé :
- Le modèle prédit la valeur attendue du paramètre à partir de mesures corrélées — par exemple, la conductivité estimée à partir du pH, de la température et de la force ionique
- La lecture du capteur physique est comparée à la prédiction
- Une divergence soutenue déclenche une vérification
C’est un outil de filtrage, pas un remplacement pour une référence physique. Sa valeur est qu’il attrape un capteur qui a dérivé en dehors de la plage que les autres mesures permettent.
Défi 2 : Connectivité et Transmission des Données
Le Problème
Les installations d’eau sont géographiquement dispersées et souvent situées là où la connectivité est mauvaise : un bassin de réservoir, une station de pompage à la limite du réseau, une usine de traitement rurale. Les lacunes de données en résultent, et un trou dans un dossier de conformité est un problème en soi, séparé de ce qui s’est passé pendant la lacune.
L’Impact sur les Systèmes IoT
- Lacunes dans les dossiers de données qui rendent l’analyse des tendances et le reporting réglementaire incomplets
- Alertes retardées qui manquent des événements qui étaient critiques en temps voulu
- Dépassement de tampon lorsque la connectivité revient et que tout se télécharge en même temps
- Décharge de batterie due à des tentatives de reconnexion répétées, ce qui réduit la durée de vie des unités distantes
Solutions Prouvées
Solution 2.1 : Architecture de Calcul de Bord
Les dispositifs de bord intelligents changent le mode de défaillance :
- Traiter et analyser les données localement lorsque le lien est coupé
- Stocker les lectures dans la mémoire locale jusqu’à ce que la transmission reprenne
- Évaluer les conditions d’alarme sans connectivité cloud
- Se synchroniser avec le système central lorsque le lien revient
Le point clé de conception est que le dispositif local doit conserver les données même en cas de perte de puissance ainsi qu’en cas de panne de réseau, car ces deux événements ont tendance à coïncider.
Solution 2.2 : Redondance Multi-Réseau
- Cellulaire LTE-M/NB-IoT comme connexion principale
- LoRaWAN pour les sites à faible consommation d’énergie sur de plus longues distances
- Satellite pour les sites sans couverture terrestre
- Wi-Fi ou fibre là où l’infrastructure existe
- Retour série/Modbus au sein d’un site
La bascule automatique entre les réseaux est ce qui rend la conception fonctionnelle ; un seul modem qui doit être réorienté manuellement n’est pas une redondance.
Solution 2.3 : Protocoles de Stockage et de Transmission
- Les paquets de données portent des horodatages et des numéros de séquence, donc les lacunes sont visibles plutôt que silencieuses
- Capacité de tampon dimensionnée en jours de lectures, pas en heures
- Compression pour prolonger la durée de vie du tampon
- Réessayer avec un temps d’attente exponentiel, afin que le dispositif ne vide pas sa batterie en luttant pour un signal
Défi 3 : Intégration et Interprétation des Données
Le Problème
La surveillance continue génère plus de données que la plupart des organisations n’en utilisent. Quelques dizaines de paramètres à une résolution minute représentent des millions de lectures par mois, et l’échec pratique n’est pas le stockage — c’est que personne ne regarde la plupart d’entre elles, donc l’investissement produit des dossiers plutôt que des décisions.
L’Impact sur les Systèmes IoT
Sans stratégie de données :
- Les opérateurs sont submergés par le volume et se contentent de surveiller une poignée d’écrans
- Des événements réels sont enfouis dans le bruit et la variation sans tendance
- Des modèles historiques qui pourraient informer des changements de processus restent non découverts
- Aucune recommandation ne peut être générée car personne n’a défini les questions
Solutions Prouvées
Solution 3.1 : Architecture d’Alerte Hiérarchique
Les alertes multi-niveaux sont le changement de valeur le plus important que la plupart des usines peuvent apporter :
| Niveau | Déclencheur | Réponse |
|---|---|---|
| Niveau 1 | Excursion d’un seul paramètre | Enregistrer et suivre |
| Niveau 2 | Excursion soutenue, ou deux paramètres liés | Notification de l’opérateur |
| Niveau 3 | Seuil critique ou un modèle connu | Alerte immédiate plus une action recommandée |
| Niveau 4 | Échec prédit ou contamination | Activation de la réponse d’urgence |
Le bénéfice n’est pas que les alertes deviennent moins nombreuses ; c’est que les alertes deviennent proportionnelles. Une seule excursion à 2 heures du matin n’a pas besoin de la même réponse qu’une tendance croissante sur trois paramètres, et séparer les deux est ce qui permet aux opérateurs de répondre à celles qui comptent.
Solution 3.2 : Analytique par Apprentissage Automatique
Là où les données historiques le permettent, l’apprentissage automatique ajoute des capacités que la logique de seuil ne peut pas :
- Détection d’anomalies qui signale des combinaisons inhabituelles plutôt que des valeurs isolées hors de portée
- Modélisation prédictive de paramètres avec des facteurs connus, tels que le temps de fonctionnement du filtre ou la demande en chlore
- Analyse des causes profondes qui corrèle une déviation avec les changements de processus qui l’ont précédée
- Recommandations d’optimisation basées sur l’historique opérationnel de l’usine
La contrainte honnête est la qualité des données. Les modèles ne sont aussi bons que l’historique de calibration derrière l’ensemble d’entraînement, c’est pourquoi le Défi 1 doit être résolu avant le Défi 3.
Solution 3.3 : Visualisation de Tableau de Bord Intégré
- Résumé au niveau de l’installation avec des tendances, de sorte que l’état de l’usine soit visible d’un coup d’œil
- Accès à un capteur spécifique et à une période de temps lorsque quelque chose doit être expliqué
- Exceptions et actions recommandées mises en avant plutôt qu’enfouies
- Contexte historique aux côtés des valeurs actuelles, afin qu’un changement puisse être comparé avec les saisons précédentes
Une bonne visualisation raccourcit le temps entre le fait de remarquer une déviation et de la comprendre. C’est là que le retour opérationnel sur la surveillance provient généralement.
Feuille de Route de Mise en Œuvre
Phase 1 : Fondation (Mois 1–3)
- Auditer le réseau de capteurs existant et identifier les points qui comptent réellement
- Déployer des capteurs avec capacité d’auto-nettoyage là où le colmatage provoque une dérive
- Installer des dispositifs de bord sur des sites distants, avec un stockage local vérifié
- Établir un historien de données central avec synchronisation temporelle documentée
Phase 2 : Intelligence (Mois 4–6)
- Configurer l’architecture d’alerte multi-niveaux et convenir des attentes de réponse avec les opérateurs
- Déployer la détection d’anomalies sur des paramètres avec suffisamment d’historique propre
- Construire les tableaux de bord des opérateurs
- Former les opérateurs sur les nouveaux flux de travail, y compris comment distinguer une alerte de dérive d’une alerte d’événement
Phase 3 : Optimisation (Mois 7–12)
- Mettre en œuvre des modèles de maintenance prédictive pour les intervalles de calibration et de nettoyage
- Développer des recommandations d’optimisation à partir de l’historique opérationnel
- Intégrer avec les systèmes SCADA et de contrôle lorsque cela est justifié
- Établir un cycle de révision qui alimente le choix des capteurs
Ce Qui Rend la Surveillance IoT Efficace
Les trois défis sont liés. La dérive sape l’analytique, la connectivité peu fiable rompt l’enregistrement des données dont la détection de dérive dépend, et une usine sans couche d’interprétation ne peut utiliser ni l’un ni l’autre. L’ordre des travaux est important : des mesures stables d’abord, une transmission fiable ensuite, des analyses et des tableaux de bord en troisième.
Aucune des solutions ne nécessite de technologie nouvelle. Elles nécessitent de décider, à l’avance, ce que le système fera lorsqu’un capteur dérive, lorsque le réseau tombe et lorsque une alerte se déclenche à une heure incommode.