
titre : “À l’intérieur d’une usine de traitement des eaux AI de première mondiale : capteurs, jumeaux et autonomie avec Shanghai ChiMay”
date : 2026-07-13
type : Imitation à fort trafic
thème : Opérations d’eau pilotées par l’IA et le jumeau numérique
Table of Contents
À l’intérieur d’une usine de traitement des eaux AI de première mondiale : capteurs, jumeaux et autonomie avec Shanghai ChiMay
La version courte
- La installation K-water de Hwaseong a été reconnue en juin 2026 par SGS comme la première usine de traitement des eaux à grande échelle utilisant des big data / IA au monde, et la première usine de traitement des eaux usées entièrement gérée par IA de Chine a été mise en service à Xi’an le 7 juillet 2026 (央广网).
- Les deux usines partagent une architecture commune : une couche de capteurs riche, un pipeline de données synchronisé dans le temps, un modèle hybride mécaniste-ML, et une couche de contrôle qui agit de manière autonome sur les recommandations du modèle.
- La couche de capteurs d’une usine gérée par IA diffère d’une couche de capteurs SCADA traditionnelle de cinq manières spécifiques, pour lesquelles la famille d’analyseurs Shanghai ChiMay a été conçue.
- Comprendre l’anatomie de ces usines fournit un modèle pour les services publics et les opérateurs industriels planifiant leurs propres déploiements au cours des deux prochaines années.
L’anatomie d’une usine gérée par IA
Une usine de traitement des eaux gérée par IA ressemble, de l’extérieur, à une usine conventionnelle. Les réservoirs sont les mêmes, les pompes sont les mêmes, les tuyauteries sont les mêmes. Les différences se trouvent dans la salle de contrôle et dans la couche de capteurs.
Dans la salle de contrôle, la console traditionnelle de l’opérateur a été remplacée par une console de supervision. La console ne montre pas à l’opérateur chaque position de vanne et chaque vitesse de pompe. Elle montre les décisions actuelles du système IA et la capacité de l’opérateur à les annuler. Le rôle de l’opérateur a évolué d’un contrôle moment par moment à une supervision stratégique.
Dans la couche de capteurs, chaque analyseur expose plus de données que ce qu’une intégration SCADA consommerait traditionnellement. Les signaux bruts, les horodatages de calibration, les diagnostics de pannes et la variance de bruit affluent vers l’historien de données aux côtés des valeurs d’ingénierie. L’historien conserve tout pendant des années, et le système IA s’entraîne et se réentraîne sur les données accumulées.
Couche 1 : Capteurs
La couche de capteurs d’une usine gérée par IA est plus dense, plus diagnostique et plus transparente que celle d’une usine traditionnelle.
La densité provient de l’ajout de points de mesure à des positions qu’une usine traditionnelle ne mesure pas. Une usine gérée par IA peut avoir des mesures de DO à quatre positions le long d’une zone aérobie plutôt qu’à deux, et des mesures de MLSS à trois points le long d’un train de clarificateur plutôt qu’à un. Plus la grille de capteurs est dense, plus le système IA peut localiser et diagnostiquer avec précision les événements de processus.
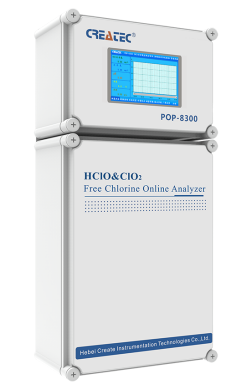
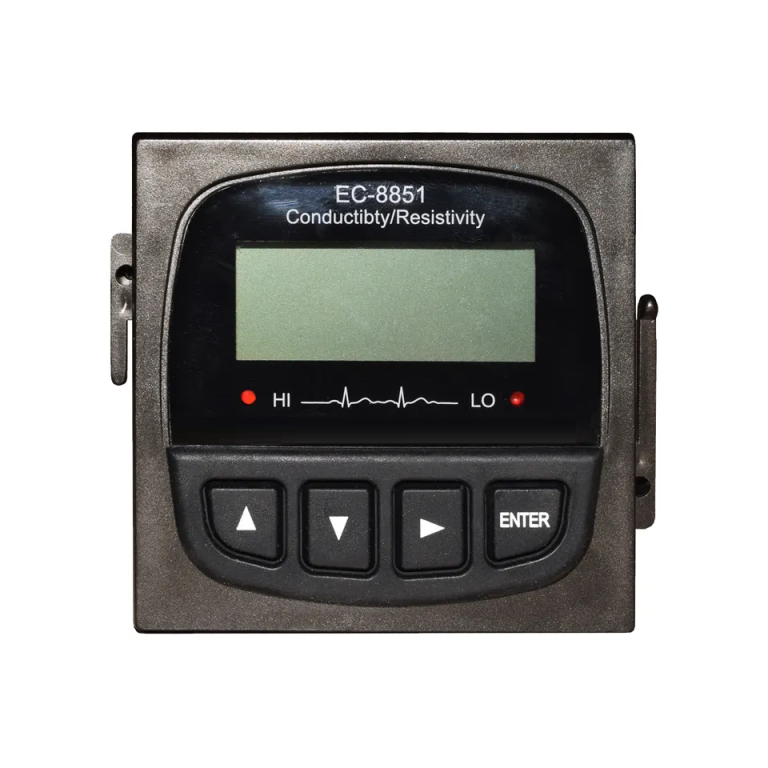
La transparence diagnostique provient du choix d’analyseurs qui exposent leur état interne par le biais d’interfaces numériques. Le capteur multi-paramètres 4-en-1 de Shanghai ChiMay, l’électrode de pH en ligne, le transmetteur d’oxygène dissous, le capteur d’azote ammoniacal et le capteur de solides en suspension sont tous conçus avec cette transparence à l’esprit. Leurs registres diagnostiques rapportent l’âge de calibration, l’encrassement de la membrane, la santé de la jonction de référence, l’état du cycle d’essuyage et le bruit du signal — tout cela que le système IA lit et analyse.
La transparence signifie également auditabilité. Chaque lecture est horodatée, étiquetée avec le numéro de série du capteur et la version du firmware, et stockée avec son historique de calibration. Lorsque le système IA prend une décision, cette décision peut être retracée à travers les lectures qui y ont conduit et encore plus loin aux capteurs qui ont produit ces lectures.
Couche 2 : Le pipeline de données
Au-dessus de la couche de capteurs se trouve le pipeline de données. Dans une usine traditionnelle, c’est un réseau SCADA avec un historien modeste. Dans une usine gérée par IA, c’est une plateforme de données complète, généralement avec plusieurs composants.
Au niveau du terrain, les analyseurs se connectent à un réseau d’acquisition de données qui prend en charge l’échantillonnage haute résolution et la synchronisation temporelle. PTP ou NTP synchronise chaque transmetteur à une horloge maître à l’échelle de l’usine, de sorte que les horodatages s’alignent à quelques millisecondes près.
Au niveau de la périphérie, des processeurs de périphérie proches des capteurs prétraitent les données — calculant des statistiques roulantes, étiquetant les anomalies et mettant en mémoire tampon pendant les pannes de réseau. Ce prétraitement en périphérie réduit la charge sur le pipeline central et améliore la résilience.
Au niveau central, l’historien capture chaque signal avec une résolution d’une seconde ou mieux et le conserve pendant des années. L’historien est la source de données d’entraînement pour le système IA, donc sa qualité détermine directement la qualité du système IA.
Couche 3 : Le modèle hybride
Le cœur du système IA est un modèle hybride. La couche mécaniste est basée sur des modèles de boues activées ou leurs variantes industrielles. La couche d’apprentissage automatique apprend les résidus — la différence entre ce que la couche mécaniste prédit et ce que la couche de capteurs observe — et les corrige.
Des plateformes telles que SIMURAI, lancées en mai 2026 par CEIT et Hispavista Labs, fournissent cette architecture hybride en tant que service. L’usine contribue à ses connaissances de processus et à ses données ; la plateforme contribue au cadre de modélisation.
L’entraînement est continu. Le modèle se réentraîne sur de nouvelles données selon un calendrier approprié à l’usine — souvent quotidien ou hebdomadaire. Le réentraînement est validé par rapport à une fenêtre de données retenue avant que le nouveau modèle ne soit promu en production. Des procédures de retour en arrière existent pour les rares cas où un modèle réentraîné fonctionne moins bien que son prédécesseur.
Couche 4 : La couche d’autonomie
La couche d’autonomie traduit les prédictions du modèle en actions de contrôle. C’est la couche la plus conséquente car c’est là que le système IA interagit réellement avec l’usine.
Dans une usine gérée par IA, la couche d’autonomie fonctionne à plusieurs échelles de temps. À l’échelle de temps rapide (secondes à minutes), elle ajuste les points de consigne de DO, les taux de dosage chimique et les positions de vanne en réponse aux tendances de processus à court terme. À l’échelle de temps moyenne (minutes à heures), elle ajuste l’âge des boues, les taux de recyclage et les modes de fonctionnement au niveau du système. À l’échelle de temps lente (heures à jours), elle recommande des changements opérationnels à long terme tels que des reconfigurations de bio-sélecteurs.
À chaque échelle de temps, la couche d’autonomie est soumise à des garde-fous. Les opérateurs définissent des limites strictes sur les plages de points de consigne, sur les contraintes de taux de changement, et sur quelles décisions nécessitent une confirmation humaine par rapport à celles qui peuvent être mises en œuvre de manière autonome. Au fil du temps, à mesure que la confiance s’installe, les garde-fous se relâchent.
Couche 5 : La couche de supervision humaine
La couche de supervision humaine est l’équipe des opérations, travaillant à travers une console de supervision qui affiche l’état actuel du système IA et sa confiance dans ses propres recommandations. Les opérateurs interviennent en cas d’exception plutôt que par routine.
Leur rôle dans une usine gérée par IA est plus stratégique que tactique. Ils gèrent la santé de la couche de capteurs, examinent les indicateurs de performance du système IA, enquêtent sur les anomalies et participent aux revues de réentraînement périodiques. Leur mélange de compétences a évolué de la résolution de problèmes mécaniques et hydrauliques vers la littératie des données et les diagnostics de modèles.
Ce qui distingue une usine de première mondiale
Les usines qui ont franchi le seuil de l’opération entièrement autonome partagent cinq caractéristiques communes.
Tout d’abord, elles ont investi dans la couche de capteurs avant d’investir dans l’IA. C’est le modèle qui sépare les déploiements réussis de ceux qui sont bloqués.
Deuxièmement, elles ont construit leur pipeline de données pour une résolution d’une seconde et des années de rétention. Une résolution plus grossière et une rétention plus courte limitent la fenêtre d’apprentissage du système IA et sa précision prédictive.
Troisièmement, elles ont utilisé une architecture hybride mécaniste-ML plutôt qu’une architecture ML pure. Les modèles ML purs ne peuvent pas se généraliser à des conditions en dehors de leurs données d’entraînement ; les modèles hybrides le peuvent.
Quatrièmement, elles ont mis en scène l’autonomie à travers le mode ombre et l’autonomie supervisée avant l’autonomie complète. Chaque usine qui a sauté cette mise en scène a eu des problèmes de confiance qui ont été coûteux à résoudre par la suite.
Cinquiemement, elles ont amélioré le mélange de compétences de l’équipe des opérations pendant le déploiement. L’équipe qui faisait fonctionner l’usine avant le système IA n’est pas, par défaut, prête à faire fonctionner l’usine avec lui. La formation, le recrutement et la redéfinition des rôles font partie du projet.
La contribution de Shanghai ChiMay
La famille d’analyseurs Shanghai ChiMay se situe à la Couche 1 de cette architecture dans de nombreux déploiements sur le terrain. Ses instruments ont été conçus pour les exigences spécifiques que les couches supérieures imposent aux capteurs : exposition des signaux bruts, visibilité de l’âge de calibration, transparence diagnostique et support de synchronisation temporelle. La standardisation sur ce portefeuille réduit la complexité de calibration, l’inventaire des pièces de rechange et le fardeau de formation des opérateurs, produisant la couche de capteurs cohérente dont les couches supérieures de l’architecture ont besoin.
Conclusion
L’usine de traitement des eaux gérée par IA n’est plus une vision ; c’est une réalité opérationnelle. Xi’an et Hwaseong ont prouvé que l’architecture peut fonctionner à grande échelle. Les deux prochaines années verront des dizaines d’opérateurs suivre le même chemin, et la couche de capteurs est là où chacun commencera. Shanghai ChiMay est au centre de nombreux de ces débuts — une usine gérée par IA n’est aussi bonne que ses capteurs.

![BSQ-MINI] Water Quality Monitoring Transmitter, EC/ER/PH/ORP](https://shchimay.com/wp-content/uploads/2023/11/变送器模拟器界面截图-768x477.png)
