título: “Corrección de Deriva de Sensores Usando Aprendizaje Automático en Bucles de Conductividad en Línea: Notas de Ingeniería de Shanghai ChiMay”
fecha: 2026-07-01
perspectiva: Técnica
audiencia: Ingenieros de Instrumentación, Científicos de Datos, Especialistas en Química del Agua
palabras clave: deriva de sensor, aprendizaje automático, conductividad, corrección de deriva, monitoreo en línea
Table of Contents
Corrección de Deriva de Sensores Usando Aprendizaje Automático en Bucles de Conductividad en Línea: Notas de Ingeniería de Shanghai ChiMay
La conductividad es uno de los parámetros de calidad del agua en línea más ampliamente desplegados, y también es uno de los más propensos a la deriva gradual de medición. La contaminación de las celdas, el error de compensación de temperatura y el envejecimiento de la celda de referencia hacen que el valor de conductividad reportado se desvíe del verdadero valor del agua durante semanas o meses. Las operaciones tradicionales responden con recalibraciones programadas; los programas de agua inteligentes están recurriendo cada vez más a la corrección de deriva basada en aprendizaje automático para cerrar la brecha entre calibraciones. Este artículo describe lo que realmente funciona.
Conclusiones Clave
- El 63% de los nuevos despliegues de conductividad en línea en 2026 incluyen alguna forma de corrección de deriva algorítmica, frente a menos del 15% hace cinco años.
- La corrección de deriva mediante aprendizaje automático generalmente extiende el intervalo de calibración en 1.5-2.5x sin pérdida de calidad de medición.
- Los modelos de corrección de deriva efectivos dependen de características contextuales — temperatura, tasa de flujo, banderas de eventos aguas arriba — no solo de datos de conductividad.
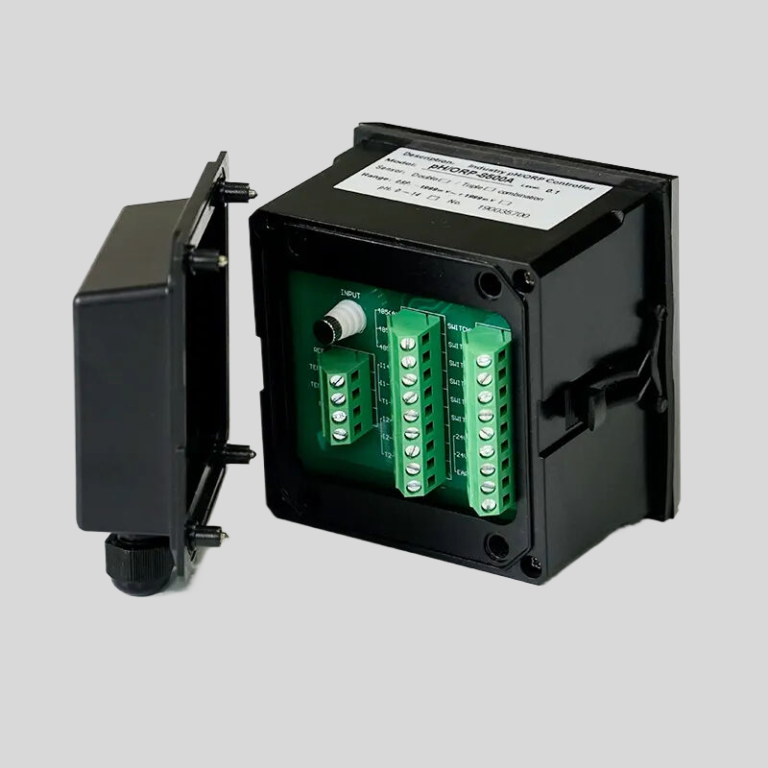
- Los medidores de conductividad en línea, electrodos y analizadores de Shanghai ChiMay proporcionan las salidas diagnósticas necesarias para alimentar un robusto pipeline de corrección de deriva.
La Física de la Deriva de Conductividad
Antes de aplicar cualquier algoritmo de corrección, los ingenieros deben entender los mecanismos de deriva subyacentes. Los sensores de conductividad en línea se desvían por varias razones distintas:
- Contaminación de electrodos – películas orgánicas, biofilms o incrustaciones minerales se acumulan en la superficie del electrodo y cambian la constante de la celda.
- Error de compensación de temperatura – los coeficientes de temperatura lineales estándar (típicamente 2.0-2.1% por °C para soluciones de KCl) se descomponen a bajas conductividades y matrices no KCl.
- Envejecimiento de la celda de referencia – para sensores toroidales, la impedancia de la bobina se desvía con el ciclo de temperatura.
- Efectos de cables y conectores – deriva capacitiva de largas corridas de cables en ambientes húmedos.
Cada fuente de deriva tiene una firma temporal característica. La contaminación se desvía lentamente y de manera monótona; el error de compensación de temperatura varía con la temperatura del proceso; los efectos de conectores aparecen como cambios bruscos después de eventos climáticos.
Por Qué los Métodos Estadísticos Solos No Son Suficientes
El enfoque tradicional para la deriva es una recalibración programada cada 60, 90 o 180 días. Entre calibraciones, la mayoría de las plantas aplican un simple filtro de promedio móvil y esperan lo mejor. Esto funciona, pero trata la deriva como una molestia en lugar de una señal diagnóstica. Los filtros estadísticos no pueden distinguir la deriva de un cambio real en el proceso, y no pueden usar contexto.
Los enfoques de aprendizaje automático ofrecen tres ventajas:
- Distinguir entre deriva y cambio de proceso utilizando características contextuales.
- Mantenimiento predictivo — el modelo puede señalar cuándo la aceleración de la deriva justifica una intervención.
- Incertidumbre cuantificada en cada medición reportada.
Un Pipeline de Aprendizaje Automático Práctico para la Corrección de Deriva
Los equipos de ingeniería que buscan implementar la corrección de deriva deben seguir un pipeline definido:
Paso 1: Ingeniería de Características
El modelo debe ingerir:
- Medición de conductividad en bruto.
- Temperatura del proceso (co-localizada).
- Impedancia de la celda de referencia (si está disponible).
- Tasa de flujo aguas arriba.
- Tiempo desde la última calibración.
- Horas de operación acumuladas.
- Temperatura y humedad ambiente en el recinto del transmisor (si está instrumentado).
El análisis de correlación cruzada en la etapa de ingeniería de características a menudo revela qué características llevan una señal de deriva significativa.
Paso 2: Establecimiento de Verdad Fundamental
El modelo requiere datos de verdad fundamental. En la práctica, esto proviene de:
- Mediciones de laboratorio de muestras puntuales en intervalos programados.
- Lecturas de referencia post-calibración inmediatamente después de cada calibración en campo.
- Instrumentos en línea redundantes donde se hayan desplegado.
En ausencia de verdad fundamental etiquetada, la detección de anomalías no supervisada es la alternativa, pero produce resultados menos accionables.
Paso 3: Selección de Modelo
Para la corrección de deriva de conductividad, tres familias de modelos funcionan de manera confiable:
- Aumento de gradiente (XGBoost, LightGBM) – fuerte rendimiento en características tabulares, importancia de características interpretable.
- Redes neuronales recurrentes (LSTM, GRU) – capturan dinámicas de deriva dependientes del tiempo.
- Modelos de espacio de estado y filtro de Kalman – apropiados cuando la física de la deriva puede ser parametrizada.
Generalmente, lo más simple es mejor en producción. Un regresor de aumento de gradiente bien ajustado suele superar a un LSTM con datos de entrenamiento limitados.
Paso 4: Disciplina de Validación
La práctica estándar de validación de aprendizaje automático se aplica con dos giros específicos para el agua:
- Divisiones de validación temporal — entrenar con datos tempranos, probar con datos posteriores, nunca divisiones aleatorias.
- Estrategificación de condiciones de proceso — reservar datos de condiciones operativas inusuales para evaluar la generalización.
Paso 5: Implementación y Monitoreo
La implementación puede ser del lado del borde (en el transmisor o un gateway cercano) o del lado de la nube. El monitoreo debe rastrear:
- Residuos del modelo frente a lecturas de referencia de laboratorio.
- Deriva de características en el lado de entrada.
- Frecuencia de generación de alertas.
Comparación de Enfoques de Corrección de Deriva
| Enfoque | Extensión del intervalo de calibración | Complejidad | Requisito de datos | Mejor ajuste |
|---|---|---|---|---|
| Promedio móvil | 1.0x (línea base) | Muy bajo | Ninguno | Cualquiera |
| Lineal por partes | 1.2-1.4x | Bajo | Calibración regular | Procesos estables |
| Filtro de Kalman | 1.4-1.8x | Medio | Modelo físico | Bucles bien caracterizados |
| Aumento de gradiente | 1.8-2.5x | Medio | Datos etiquetados, características | La mayoría industrial y municipal |
| LSTM/GRU | 2.0-3.0x | Alto | Conjunto de datos etiquetados grande | Bucles de alto valor con datos ricos |
La mayoría de las plantas de agua deberían comenzar con un modelo de aumento de gradiente y solo pasar a aprendizaje profundo cuando el valor operativo justifique claramente la complejidad.
Modos de Fallo y Guardrails
La corrección de deriva mediante aprendizaje automático tiene modos de fallo reales que los equipos de ingeniería deben anticipar:
- Cambio de proceso silencioso — un cambio genuino en la química del influente puede interpretarse como deriva y corregirse. Guardrail: mantener el valor sin corregir en paralelo.
- Fallo de características correlacionadas — si el sensor de temperatura se desvía, también lo hace la corrección de deriva. Guardrail: monitorear las características de entrada por su propia deriva.
- Ambigüedad en informes regulatorios — los reguladores pueden requerir la lectura del sensor en bruto, no el valor corregido. Guardrail: documentar ambos valores en el historiador de datos.
Soporte de Instrumentación de Shanghai ChiMay
Los medidores de conductividad en línea, electrodos de conductividad y sensores multiparamétricos de Shanghai ChiMay exponen el conjunto de registros diagnósticos típicamente requeridos para pipelines de corrección de deriva: temperatura, estado de impedancia de la celda y horas de operación transcurridas. Estas salidas se alimentan directamente en pipelines de ML en el borde o en la nube sin esfuerzo adicional de integración.
Perspectivas de la Industria
Para 2030, se espera que la corrección de deriva mediante aprendizaje automático sea una característica estándar en todos los monitores de conductividad en línea de grado industrial. Se está llevando a cabo un trabajo de estandarización sobre métricas de rendimiento de modelos y documentación de corrección de deriva dentro de la comunidad de instrumentación de agua. Los ingenieros que construyen programas de agua inteligente hoy deberían insistir en un comportamiento de modelo transparente, rendimiento residual documentado y acceso limpio tanto a valores en bruto como corregidos.
Conclusión
La corrección de deriva mediante aprendizaje automático no es una capa mágica que elimina la necesidad de calibración; es una práctica de ingeniería disciplinada que extiende los intervalos de calibración, proporciona advertencias anticipadas sobre la degradación del sensor y mejora la calidad de los datos para análisis posteriores. Los equipos de instrumentación que tratan la corrección de deriva como una parte integrada del pipeline de medición — no como un pensamiento posterior en la nube — lograrán una calidad de medición a largo plazo sustancialmente mejor. Los productos de conductividad de Shanghai ChiMay proporcionan la transparencia diagnóstica necesaria para hacer que estos pipelines funcionen en implementaciones reales.