titre : “Correction de la dérive des capteurs utilisant l’apprentissage automatique dans les boucles de conductivité en ligne : Notes d’ingénierie de Shanghai ChiMay”
date : 2026-07-01
perspective : Technique
audience : Ingénieurs en instrumentation, Scientifiques des données, Spécialistes de la chimie de l’eau
mots-clés : dérive des capteurs, apprentissage automatique, conductivité, correction de la dérive, surveillance en ligne
Table of Contents
Correction de la dérive des capteurs utilisant l’apprentissage automatique dans les boucles de conductivité en ligne : Notes d’ingénierie de Shanghai ChiMay
La conductivité est l’un des paramètres de qualité de l’eau en ligne les plus largement déployés, et elle est également l’un des plus sujets à une dérive de mesure progressive. Le colmatage des cellules, l’erreur de compensation de température et le vieillissement des cellules de référence provoquent tous une divergence de la valeur de conductivité rapportée par rapport à la véritable valeur de l’eau sur des semaines à des mois. Les opérations traditionnelles réagissent par une recalibration programmée ; les programmes d’eau intelligents se tournent de plus en plus vers la correction de dérive basée sur l’apprentissage automatique pour réduire l’écart entre les recalibrations. Cet article décrit ce qui fonctionne réellement.
Principaux enseignements
- 63 % des nouveaux déploiements de conductivité en ligne en 2026 incluent une forme de correction de dérive algorithmique, contre moins de 15 % il y a cinq ans.
- La correction de dérive par apprentissage automatique prolonge généralement l’intervalle de calibration de 1,5 à 2,5 fois sans perte de qualité de mesure.
- Les modèles de correction de dérive efficaces s’appuient sur des caractéristiques contextuelles — température, débit, indicateurs d’événements en amont — et non uniquement sur les données de conductivité.
- Les mètres de conductivité en ligne, les électrodes et les analyseurs de Shanghai ChiMay fournissent les sorties de diagnostic nécessaires pour alimenter un pipeline de correction de dérive robuste.
La physique de la dérive de conductivité
Avant d’appliquer un algorithme de correction, les ingénieurs doivent comprendre les mécanismes de dérive sous-jacents. Les capteurs de conductivité en ligne dérivent pour plusieurs raisons distinctes :
- Colmatage des électrodes – des films organiques, des biofilms ou des dépôts minéraux s’accumulent sur la surface de l’électrode et modifient la constante de cellule.
- Erreur de compensation de température – les coefficients de température linéaires standard (typiquement 2,0-2,1 % par °C pour les solutions de KCl) se dégradent à faibles conductivités et dans des matrices non-KCl.
- Vieillissement de la cellule de référence – pour les capteurs toroïdaux, l’impédance de la bobine dérive avec le cycle de température.
- Effets des câbles et des connecteurs – dérive capacitive due à de longs câbles dans des environnements humides.
Chaque source de dérive a une signature temporelle caractéristique. Le colmatage dérive lentement et de manière monotone ; l’erreur de compensation de température varie avec la température du processus ; les effets des connecteurs apparaissent comme des changements brusques après des événements météorologiques.
Pourquoi les méthodes statistiques à elles seules ne suffisent pas
L’approche traditionnelle de la dérive consiste en une recalibration programmée tous les 60, 90 ou 180 jours. Entre les recalibrations, la plupart des usines appliquent un simple filtre de moyenne mobile et espèrent le meilleur. Cela fonctionne, mais cela traite la dérive comme une nuisance plutôt que comme un signal de diagnostic. Les filtres statistiques ne peuvent pas distinguer la dérive d’un véritable changement de processus, et ils ne peuvent pas utiliser le contexte.
Les approches d’apprentissage automatique offrent trois avantages :
- Distinction entre dérive et changement de processus utilisant des caractéristiques contextuelles.
- Maintenance prédictive — le modèle peut signaler quand l’accélération de la dérive nécessite une intervention.
- Incertitude quantifiée sur chaque mesure rapportée.
Un pipeline ML pratique pour la correction de dérive
Les équipes d’ingénierie cherchant à déployer une correction de dérive devraient suivre un pipeline défini :
Étape 1 : Ingénierie des caractéristiques
Le modèle devrait ingérer :
- Mesure de conductivité brute.
- Température du processus (co-localisée).
- Impédance de la cellule de référence (si disponible).
- Débit en amont.
- Temps écoulé depuis la dernière calibration.
- Heures de fonctionnement cumulées.
- Température et humidité ambiantes dans l’enveloppe de l’émetteur (si instrumenté).
L’analyse de corrélation croisée à l’étape d’ingénierie des caractéristiques révèle souvent quelles caractéristiques portent un signal de dérive significatif.
Étape 2 : Établissement de la vérité de terrain
Le modèle nécessite des données de vérité de terrain. En pratique, cela provient de :
- Mesures de laboratoire par échantillonnage à intervalles programmés.
- Lectures de référence post-calibration immédiatement après chaque calibration sur le terrain.
- Instruments en ligne redondants où déployés.
En l’absence de vérité de terrain étiquetée, la détection d’anomalies non supervisée est le recours, mais elle produit des résultats moins exploitables.
Étape 3 : Sélection du modèle
Pour la correction de dérive de conductivité, trois familles de modèles fonctionnent de manière fiable :
- Gradient boosting (XGBoost, LightGBM) – performance solide sur des caractéristiques tabulaires, importance des caractéristiques interprétable.
- Réseaux de neurones récurrents (LSTM, GRU) – capturent la dynamique de dérive dépendante du temps.
- Modèles d’état-espace et filtre de Kalman – appropriés lorsque la physique de la dérive peut être paramétrée.
Plus simple est généralement mieux en production. Un régresseur à gradient boosté bien réglé surpasse généralement un LSTM sur des données d’entraînement limitées.
Étape 4 : Discipline de validation
La pratique standard de validation en apprentissage automatique s’applique avec deux particularités spécifiques à l’eau :
- Splits de validation temporelle — entraîner sur des données anciennes, tester sur des données récentes, jamais des splits aléatoires.
- Stratification des conditions de processus — exclure des données provenant de conditions de fonctionnement inhabituelles pour évaluer la généralisation.
Étape 5 : Déploiement et surveillance
Le déploiement peut être côté edge (sur l’émetteur ou une passerelle à proximité) ou côté cloud. La surveillance doit suivre :
- Résidus du modèle par rapport aux lectures de référence en laboratoire.
- Dérive des caractéristiques du côté des entrées.
- Fréquence de génération d’alertes.
Comparaison des approches de correction de dérive
| Approche | Extension de l’intervalle de calibration | Complexité | Exigence de données | Meilleur ajustement |
|---|---|---|---|---|
| Moyenne mobile | 1,0x (de base) | Très faible | Aucune | Tous |
| Linéaire par morceaux | 1,2-1,4x | Faible | Calibration régulière | Processus stables |
| Filtre de Kalman | 1,4-1,8x | Moyenne | Modèle physique | Boucles bien caractérisées |
| Gradient boosting | 1,8-2,5x | Moyenne | Données étiquetées, caractéristiques | La plupart des applications industrielles et municipales |
| LSTM/GRU | 2,0-3,0x | Élevée | Grand ensemble de données étiquetées | Boucles de grande valeur avec des données riches |
La plupart des usines d’eau devraient commencer par un modèle à gradient boosté et ne passer à l’apprentissage profond que lorsque la valeur opérationnelle justifie clairement la complexité.
Modes de défaillance et garde-fous
La correction de dérive par apprentissage automatique présente de réels modes de défaillance que les équipes d’ingénierie doivent anticiper :
- Changement de processus silencieux — un changement réel dans la chimie des effluents peut être interprété comme une dérive et corrigé. Garde-fou : garder la valeur brute non corrigée disponible en parallèle.
- Échec de caractéristiques corrélées — si le capteur de température dérive, la correction de dérive le fait aussi. Garde-fou : surveiller les caractéristiques d’entrée pour leur propre dérive.
- Ambiguïté dans les rapports réglementaires — les régulateurs peuvent exiger la lecture brute du capteur, et non la valeur corrigée. Garde-fou : documenter les deux valeurs dans l’historien de données.
Support en instrumentation de Shanghai ChiMay
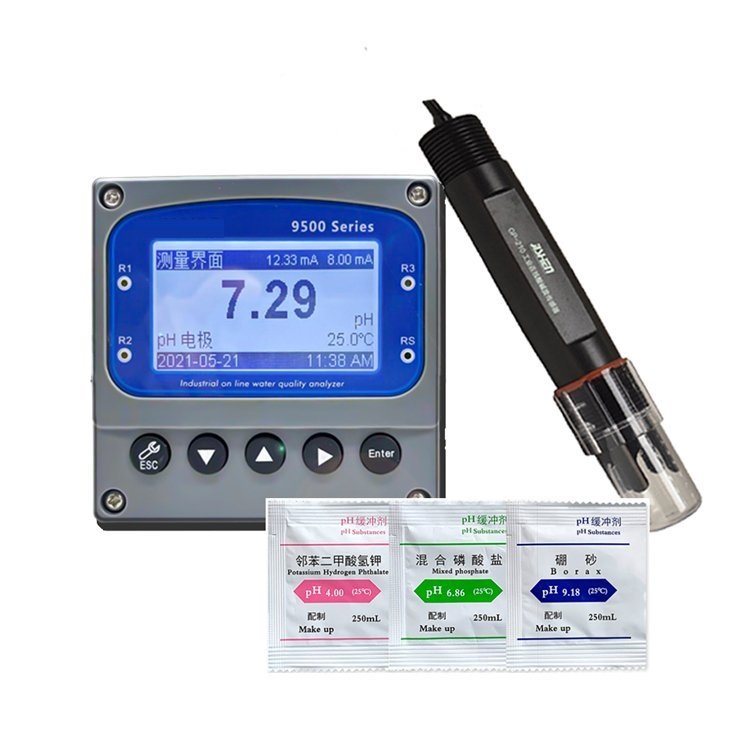
Shanghai ChiMay mètres de conductivité en ligne, électrodes de conductivité et capteurs multi-paramètres exposent l’ensemble d’enregistrements de diagnostic généralement requis pour les pipelines de correction de dérive : température, état de l’impédance de la cellule, et heures de fonctionnement écoulées. Ces sorties alimentent directement les pipelines ML edge ou cloud sans effort d’intégration supplémentaire.
Perspectives de l’industrie
D’ici 2030, la correction de dérive par apprentissage automatique devrait être une fonction standard sur tous les moniteurs de conductivité en ligne de qualité industrielle. Un travail de normalisation sur les métriques de performance des modèles et la documentation de correction de dérive est en cours au sein de la communauté de l’instrumentation de l’eau. Les ingénieurs construisant des programmes d’eau intelligents aujourd’hui devraient insister sur un comportement de modèle transparent, une performance résiduelle documentée, et un accès clair aux valeurs brutes et corrigées.
Conclusion
La correction de dérive par apprentissage automatique n’est pas une couche magique qui élimine le besoin de calibration ; c’est une pratique d’ingénierie disciplinée qui prolonge les intervalles de calibration, fournit un avertissement plus précoce de la dégradation des capteurs, et améliore la qualité des données pour les analyses en aval. Les équipes d’instrumentation qui considèrent la correction de dérive comme une partie intégrée du pipeline de mesure — et non comme une réflexion après coup dans le cloud — obtiendront une qualité de mesure à long terme substantiellement meilleure. Les produits de conductivité de Shanghai ChiMay fournissent la transparence diagnostique nécessaire pour faire fonctionner ces pipelines dans des déploiements réels.